SSE 팬아웃 인스턴스 불일치
이벤트를 만든 인스턴스와 사용자 연결을 쥔 인스턴스가 달라 로컬 팬아웃이 유실된 것이며, 그 상태가 이미 공유 저장소에 있으면 팬아웃을 걷어내고 폴링으로 읽는다.
목차
배포 모니터링 화면이 도중에 멈춘다. SSE 연결은 살아 있고 하트비트도 계속 오는데 이벤트만 오지 않는다. 에러도 재연결도 로그도 없다. 새로고침하면 그제야 최신 상태가 보인다. 배포가 끝나도 완료 신호가 오지 않아 화면이 계속 대기 상태로 남는 경우도 있다. 로컬과 단일 인스턴스에서는 재현되지 않는다.
신고를 받으면 "가끔"의 모양부터 물어본다. 붙을 때마다 되기도 하고 안 되기도 하는지, 아니면 특정 사용자만 계속 안 되는지를 가른다. 뒤쪽이라면 이벤트가 특정 인스턴스에서만 만들어지는지 먼저 확인한다.
어긋나는 두 갈래
SSE emitter를 프로세스 로컬 맵에 들고 있는데, 이벤트를 처리한 인스턴스와 사용자 연결을 쥔 인스턴스가 다르다. 로드밸런서는 연결을 아무 인스턴스에나 꽂는다.
첫 번째 갈래는 리더 전용 작업이다. 외부 상태 감시를 중복으로 처리하지 않으려고 Lease 리더 선출로 한 대에서만 돌린다. 그러면 이벤트는 늘 리더에서 발생한다. 사용자 연결이 리더에 붙을 이유는 없다. 실시간 이벤트만 놓고 보면 리더에 붙은 연결만 즉시 갱신된다. 다만 별도의 주기 스냅샷이나 재조회 경로가 있으면 다른 연결도 뒤늦게 따라잡을 수 있다. 전체 현황 화면에는 이런 완화 장치가 있었지만 개별 배포의 진행 이력 화면에는 없어서 증상이 서로 달랐다.
두 번째 갈래는 요청과 스케줄러를 처리한 인스턴스다. 파이프라인 이벤트가 여기서 발생한다. 처리하는 인스턴스가 매번 달라지므로 증상이 확률로 나타난다.
@TransactionalEventListener나 ApplicationEventPublisher는 애플리케이션 컨텍스트 안의 이벤트라 프로세스 밖으로 나가지 못한다. 리스너 하나 안에서 DB 기록은 공유 저장소로 나가는데 팬아웃만 자기 힙에 남는다.
하트비트가 이 상태를 덮는다. 연결 자체는 멀쩡하니 클라이언트가 알아챌 방법이 없다.
종료 신호도 같은 로컬 맵을 쓰면 스트림이 닫히지 않는다. 갱신 유실은 새로고침으로 넘어가지만 이것은 넘어가지 않는다. 회수하지 못한 emitter가 인스턴스마다 쌓인다.
핵심 문제는 SSE 자체가 아니다. 처리를 한 대로 모은 결정과 연결을 여러 대로 흩은 결정이 서로 반대인데, 그 사이에 인메모리 상태가 놓였다. 리더 선출도 로드밸런싱도 따로 보면 맞는 결정이라 리뷰에서 걸리지 않는다. 배치 진행률을 리더에서 계산해 메모리에 들고 있거나, 스케줄러 결과를 로컬 캐시에 넣고 아무 인스턴스에서나 읽는 구조도 똑같이 깨진다.
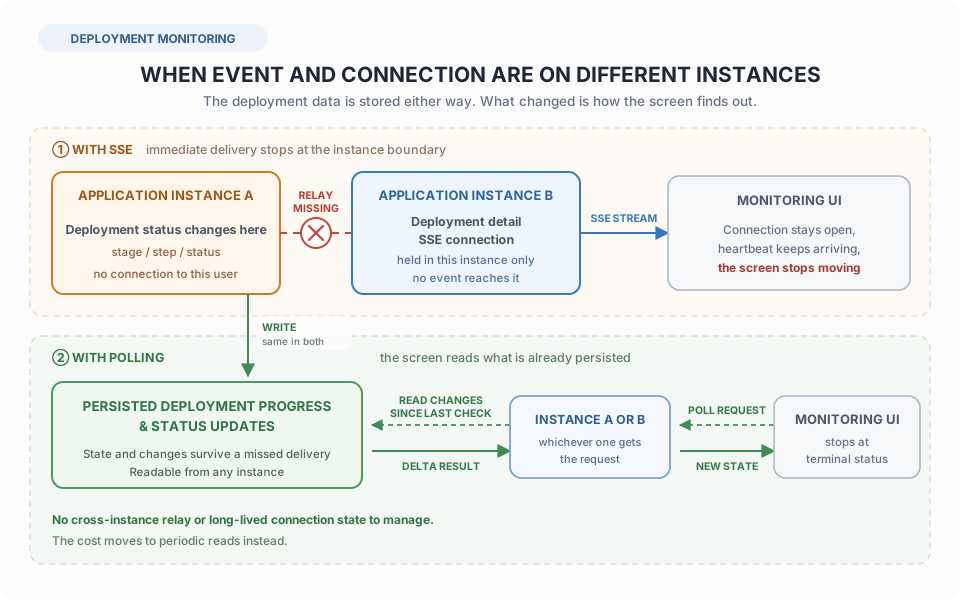
이미 저장소에 있는 상태인지부터 본다
그 상태가 이미 공유 저장소에 있는지부터 확인한다. 이 사례의 배포 모니터링 서비스는 팬아웃 직전에 이미 DB에 쓰고 있었다. 로컬 팬아웃만 걷어내면 어느 인스턴스로 가도 같은 값을 읽는다. 새 인프라를 들인 것이 아니라 원래 있던 것을 남겼을 뿐이다.
놓치면 사라지는 이벤트인지, 저장소에 남는 현재 상태인지를 다시 묻는다. 뒤쪽이라면 주기 조회로 충분하다. 한 번 늦어도 다음 조회에서 따라잡는다.
실시간성이 정말 필요할 때만 인스턴스 간 중계를 만든다. Kafka가 이미 있어도 바로 되지는 않는다. consumer group은 일을 나눠 갖는 모델이라 팬아웃과 방향이 반대다. 인스턴스마다 고유한 group.id를 줘야 하고, 그러면 컨슈머 그룹의 수명이 Pod 수명에 묶인다. 스케일아웃과 롤링 배포마다 그룹이 생겼다 사라지고 오프셋이 남는다. 종료 신호도 같은 길로 내보내야 한다. 토픽 하나를 파는 일이 아니라 팬아웃용 소비 모델과 운영 규약을 새로 만드는 일이다.
sticky session으로 연결을 고정해도 이벤트가 다른 인스턴스에서 생기는 문제는 그대로 남는다. 롤링 배포나 인스턴스 소실로 연결 대상이 바뀔 때의 복구 경로도 따로 필요하다.
원인을 좁힐 때는 리더 선출을 쓰고 있는지부터 본다. 쓰고 있다면 로그에서 현재 리더를 찾아 거기에 직접 붙어 본다. 리더에서만 정상이면 인스턴스 간 전달 경로를 의심할 근거가 된다. 실제 요청을 처리한 인스턴스와 이벤트가 발생한 인스턴스를 로그로 대조한다. 리더 선출이 없다면 재현 환경에서 인스턴스를 한 대로 줄였을 때 증상이 멈추는지 본다.
설계할 때는 한 대에서만 도는 작업과 아무 데나 붙는 연결이 만나는 자리를 먼저 찾는다. 그 사이에 인메모리 상태가 있으면 같은 문제다.
확인 범위
이 사례에서는 배포 모니터링 화면의 SSE 팬아웃을 걷어내고 API 폴링으로 바꿨고, 프로세스 로컬 emitter 맵과 주기 스냅샷 코드를 함께 제거했다. Kafka 팬아웃과 sticky session은 검토한 선택지이며 적용하지 않았다.